Na LinkedIn pojawiły się ostatnio dwa dobre wątki: jeden o klauzulach, które warto wpisać do umowy z dostawcą systemu AI, drugi o darmowych narzędziach i o tym, że firma często nie wie, z czego korzystają jej pracownicy. Oba pisane od strony prawnej. Zostawiłem pod nimi komentarze, zaczepiłem dwie rzeczy i obiecałem je rozwinąć. To jest ten tekst – kilka słów z perspektywy osoby, która buduje programy AI dla prawników.
Uprzedzam: nie jestem prawnikiem. Piszę o tym, co widzę w regulaminach, umowach powierzenia i w ruchu sieciowym, kiedy wybieram dostawcę API i decyduję, co program może wysłać, a czego nie wyśle nigdy.
1. Kto właściwie jest dostawcą Twojego AI
Kupujesz program AI i masz w głowie jednego kontrahenta. Realnie jest ich kilku.
Dostawcą modelu jest ten, kto uruchamia go na maszynie. Ta maszyna zwykle nie należy do niego, tylko jest wynajęta w cudzym centrum danych. Nad tym siedzi warstwa pośrednicząca, czyli proxy dostawcy oprogramowania, która pozwala sprawdzić licencję, limity, czy dodać coś do kontekstu. Jest też ogniwo, o którym mało kto pamięta: magazyn na kopie zapasowe, który leży w osobnej usłudze, czasem u innej firmy i w innym kraju.
Warto wiedzieć, kto realnie ma dostęp do tych danych. Formalnie nie odpowiadasz za każde ogniwo tego łańcucha, ale gdy coś pójdzie nie tak, to Ty będziesz się tłumaczył klientowi.
U mnie ten łańcuch jest krótki. Proxy to moja własna aplikacja na serwerze OVH, czyli firmy francuskiej. Promptów nie zapisuję, ale nie ukrywam oczywistego: muszę je przekazać dalej. API modelu jest obecnie również w OVH, na maszynie we Francji. Czyli dziś to jedna firma, jedna umowa powierzenia i jedno, unijne prawo. Słowo „obecnie” jest w tym akapicie celowo i wrócę do niego w punkcie czwartym.
Powiem też o rzeczy, której marketing nie mówi, choć stoi w umowie. Nawet europejski dostawca ma spółki poza Europą, a umowa dopuszcza zdalny dostęp do treści, gdy jest to konieczne do świadczenia usługi, na przykład przy aktualizacjach. Zabezpieczeniem są standardowe klauzule umowne i to, że wybranej lokalizacji centrum danych dostawca nie może zmienić bez zgody klienta. Warto zapamiętać, że „serwer w Europie” i „nikt spoza Europy nie ma technicznej możliwości dostępu” to dwa różne stwierdzenia.
2. EOG nie oznacza, że dane nie mogą trafić do USA
„Infrastruktura w EOG” mówi, gdzie stoi serwer. Nie mówi, kto nim zarządza. Firma z USA podlega prawu amerykańskiemu niezależnie od tego, w której serwerowni trzyma dane. Amerykańskie przepisy sięgają danych, nad którymi firma sprawuje kontrolę, także tych fizycznie leżących w Europie. Serwer w Irlandii czy Niemczech nie wyprowadza spółki spod jurysdykcji jej własnego kraju.
Do tego dwie rzeczy, o których u nas mało się mówi. Decyzja o adekwatności dla transferów do USA obowiązuje, ale ma rysę: skargę na nią sąd unijny oddalił we wrześniu 2025, sprawa poszła jednak do TSUE, a amerykański organ nadzorczy PCLOB od stycznia 2025 nie ma kworum. Druga – w maju 2025 amerykański sąd nakazał OpenAI zachowywać logi wbrew ich własnej zasadzie kasowania danych. Nakaz uchylono dopiero pod koniec września i to z wyjątkami. Warto pamiętać, że coś, co już się wydarzyło może wydarzyć się ponownie i wtedy żadna klauzula umowna tego nie powstrzyma.
Jak to wygląda w moim przypadku? W umowie powierzenia mojego dostawcy jest punkt, który mówi, że wniosek organu spoza Europy o dane europejskiego klienta zostaje odrzucony. Wyjątki są trzy: umowa międzynarodowa o pomocy prawnej, dane leżące w centrum danych poza Unią oraz sytuacje z artykułu 49 RODO. Jest też zobowiązanie, żeby uprzedzić klienta, o ile prawo tego nie zakazuje. Szczególnie istotny jest drugi wyjątek, bo pokazuje, gdzie leży granica – wystarczy, że dane wylądują poza Unią.
Co leży, to ktoś może dostać
Powyższe dotyczy uzyskania legalnego dostępu do danych. Jest też druga opcja – ktoś się włamuje i kopiuje bazę. W obu przypadkach działa ta sama zasada: wydać albo ukraść można tylko to, co leży. A leży zwykle więcej i dłużej, niż się pamięta. Pod koniec września dostałem zawiadomienie o naruszeniu od dostawcy usługi w chmurze. Kopiowanie szło od najstarszych rekordów, więc w całości poszły dokumenty sprzed ponad pięciu lat. Pamiętaj, że chociaż wyciek jest u dostawcy, to obowiązki zostają u Ciebie.
3. Trening, retencja czyli gdzie faktycznie leży problem
Te dwa pojęcia notorycznie się sklejają.
Model nie uczy się w czasie rzeczywistym. Wysłanie dokumentu do czatu nie oznacza, że za pięć minut ten sam fragment wyjdzie komuś innemu. To nie znaczy jednak, że trening nie istnieje. On po prostu dzieje się później i na tym, co zostało wcześniej zapisane. Dlatego pytanie o retencję jest ważniejsze niż pytanie o trening: jeśli nic nie zostaje zapisane, nie ma z czego trenować. Jeśli zostaje – musisz polegać na deklaracji dostawcy.
API jest bezstanowe, ale to nie znaczy, że nie ma logów. U dużych dostawców standardem jest trzymanie zapytań przez około trzydzieści dni na potrzeby kontroli nadużyć. Brak retencji jest możliwy, tylko jest osobnym ustaleniem, zwykle przy płatnym planie i na wniosek. Nie jest to stan domyślny. Warto również zwrócić uwagę na sam sposób odpytania modelu, bo tryby agentowe i pamięć podręczna kontekstu z natury trzymają dane dłużej niż zwykłe zapytanie.
Jest jeszcze warstwa, o której zapomina się najczęściej, bo wszyscy patrzą na model: historia rozmów po stronie samego programu. Jeśli narzędzie trzyma czat, żeby można było do niego wrócić, dane leżą u dostawcy oprogramowania niezależnie od tego, co obiecuje dostawca modelu. Do tego dochodzą logi aplikacji, proxy, telemetria i kopie zapasowe, więc stwierdzenie „usuwamy Twoje dane” jest dość nieprecyzyjne.
Pamięć asystenta też jest retencją
Popularne czaty mają dziś pamięć między rozmowami. Asystent sam wybiera z czatu to, co może się przydać później, i zapisuje na koncie u dostawcy. To wygodna funkcja i sam z niej korzystam. Na kontach indywidualnych bywa włączona domyślnie, więc można ją mieć i o tym nie wiedzieć.
To po prostu kolejny zbiór. Skasowanie czatu nie usuwa tego, co z niego trafiło do pamięci. Prawie nikt tam nie zagląda, a ilość danych codziennie rośnie. Dostawcy co prawda stosują filtry, które ograniczają to, co trafia do pamięci, ale nie oznacza to, że nie znajdą się tam dane klienta, który dla modelu jest po prostu „projektem”.
Co z tym zrobić? Raz na jakiś czas zajrzeć w ustawienia i przejrzeć, co tam leży. A przy pracy poufnej wyłączyć pamięć, o ile narzędzie na to pozwala, albo skorzystać z trybu incognito. Incognito również przechowa dane, ale znacznie krócej niż pamięć.
Reasumując. Jeśli dostawca trzyma zapytania przez określony czas to warto wiedzieć, co tam leży, kto ma do tego dostęp i jak długo. Jeśli nie trzyma nic, pytanie znika razem ze zbiorem. Im mniej danych zostaje po stronie dostawcy, tym mniejsze są skutki ewentualnego incydentu.
4. Model może się zmienić pod Tobą i czasem musi
Klauzula o powiadamianiu o zmianach w systemie ma sens tylko wtedy, gdy obejmuje zmianę modelu i sposobu kierowania zapytań.
Dostawca może przełączyć ruch na inny model z wielu powodów. Bo jest tańszy. Bo automatyczny router dobiera model do typu zapytania. Bo skończył się limit i zapytanie poszło ścieżką zapasową. Bo model został wycofany, a takie wycofania mają swoje terminy i nikogo o zdanie nie pytają. Umowa się nie zmienia, ekran się nie zmienia, a ta sama sprawa dostaje inną odpowiedź niż tydzień temu.
W swoich rozwiązaniach zastrzegam sobie prawo zmiany dostawcy API i modelu. Warunki mogą się zmienić, może pojawić się coś lepszego, coś może przestać działać z dnia na dzień i wtedy nie ma czasu na procedury. Stałe zostają trzy warunki brzegowe: dane przetwarzane w Europie, europejska firma jako dostawca API, model o otwartych wagach. To one, a nie nazwa konkretnego modelu, są obietnicą, którą składam.
Czy klauzula o powiadomieniu jest w ogóle realna do wywalczenia? W standardowej umowie powierzenia mojego dostawcy infrastruktury już istnieje, tylko dotyczy zmiany podmiotu podprzetwarzającego. Dostawca nie ma jednak obowiązku odstąpić od zmiany. Masz prawo wiedzieć i prawo odejść, nie masz prawa weta. To jest realistyczny wzorzec także dla klauzuli o zmianie modelu.
I tu dochodzimy do konkluzji. Prawo odejścia jest warte dokładnie tyle, ile kosztuje odejście. Gdy narzędzie jest już wdrożone, ludzie przeszkoleni, a codzienne procesy ułożone wokół niego, zmiana dostawcy przestaje być decyzją techniczną i staje się projektem: nowe szkolenia, nowe nawyki, przestój, migracja szablonów i danych. Dostajesz więc powiadomienie, wyrażasz sprzeciw, dostawca go nie uwzględnia i zostajesz z wyborem między akceptacją zmiany, a kosztem na który nikt w kancelarii nie ma ochoty w środku roku.
5. Jak wybierałem dostawcę i dlaczego to nie było łatwe?
Kryteria miałem trzy: czystość warunków, zgodność z RODO i to, co polityka mówi o logach. Pierwsza myśl była oczywista, czyli podpiąć się pod API dużego dostawcy. Wielu twórców tak właśnie robi, bo wdrożenie jest proste, a przy okazji dostajesz dostęp do najlepszych modeli na rynku. Po przeczytaniu warunków lista skurczyła się szybciej, niż zakładałem.
Większość liczących się firm to firmy z USA. Anthropic w swoich materiałach pisze wprost, że dane przechowuje w Stanach, a klient komercyjny może co najwyżej wybrać, dokąd kierowany jest ruch. Nie każdy punkt końcowy OpenAI stoi na europejskiej infrastrukturze, a rezydencja danych w Europie to osobna konfiguracja, o którą trzeba wystąpić. U wielu dostawców napis o EOG dotyczy zresztą ich warstwy pośredniczącej, a nie maszyny, na której stoi model.
Efekt jest taki, że z listy wypadły najpopularniejsze modele, te, których nazwy zna każdy. Zostały modele europejskie i modele otwarte: polskie, chińskie i amerykańskie, ale uruchamiane u dostawcy, którego wybieram sam. Nie ukrywam, że przez chwilę tego żałowałem, bo dobrze się sprzedaje zdanie, że program działa na modelu, którego nazwę każdy zna.
Wybrałem model o otwartych wagach z dwóch powodów. Taki dostawca nie potrzebuje Twoich danych do rozwijania własnego modelu.. Dodatkowo taki model nie zniknie przy najbliższej aktualizacji, a w razie potrzeby da się go postawić u innego dostawcy lub na maszynie w kancelarii, więc pracę można przenieść jeden do jednego.
Co mam na papierze: brak treningu na przesyłanych danych i brak retencji poza tym, co potrzebne do rozliczenia, umowę powierzenia, a w niej zapis, że po zakończeniu usługi kasowana jest cała zawartość razem z kopiami zapasowymi, automatycznie i nieodwracalnie, chyba że co innego wynika z żądania organu lub z przepisów.
I uwaga, która brzmi wbrew moim interesom. To wszystko jest zobowiązaniem umownym, a nie czymś co można łatwo sprawdzić. Sprawdzalne jest to, co dzieje się na Twoim komputerze, i dlatego zbudowałem program tak, jak opisuję na końcu.
6. Darmowe konto ma cenę, tylko płatną w innej walucie
Regulaminy wersji darmowej i płatnej potrafią się różnić u tego samego dostawcy.
W warunkach Gemini API stoi, że w wersji bezpłatnej treści służą rozwojowi produktów Google, a dane mogą czytać ludzie. Zalecają, by nie wysyłać informacji poufnych. W wersji płatnej takiego użycia nie ma. U Mistrala darmowy poziom domyślnie może zasilać trening, a wersja płatna pozwala to wyłączyć. To nie jest straszenie tylko postanowienie regulaminu, który akceptuje pracownik klikający „załóż konto”.
Jest z tym trochę jak z mediami społecznościowymi: za darmowe konto płacimy informacjami. Różnica polega na tym, że w firmie tymi informacjami są akurat te dane, o które się boimy. Umowa klienta, CV kandydatów, korespondencja, wewnętrzny raport. Nie ma tam umowy powierzenia, nie ma listy podprzetwarzających i nie ma raportu z tego, co wyszło na zewnątrz. Rachunek wystawia się w chwili wrzucenia pliku, tylko nie przychodzi w formie faktury.
Kolejność działania, którą widziałem w tamtym wątku o shadow AI, jest przy tym idealna: najpierw zapytać ludzi, z czego korzystają, potem pisać zasady.
7. Anonimizacja czy pseudonimizacja
Zacznę od siebie, bo inaczej byłoby nieuczciwie. Na stronie piszę „anonimizacja”, bo tak mówi rynek i każdy wie, o co chodzi. Technicznie w moim programie jest pseudonimizacja: dane zamieniane są na znaczniki, a słownik pozwalający je przywrócić leży wyłącznie na Twoim komputerze.
Różnica ma skutki prawne, bo dane pseudonimizowane nadal są danymi osobowymi w rozumieniu RODO. Anonimizacja jest nieodwracalna. Dlatego przy każdym narzędziu, które chwali się anonimizacją, warto zadać jedno pytanie: gdzie leży klucz. Jeśli w chmurze, cała operacja traci sens, bo dane osobowe i tak już poszły w świat…
8. Chwyty, które widuję na rynku
Na co jeszcze warto zwracać uwagę?
„Pliki nie opuszczają Twojego komputera”. Zdanie prawdziwe i mylące naraz. Sprawdziłem to. Plik faktycznie zostaje ale na zewnątrz idzie jego treść przerobiona na tekst, w całości. Dla tajemnicy zawodowej nie ma różnicy, czy wysłano PDF, czy jego zawartość.
„Nasze AI nie halucynuje”. Można wsadzić między bajki. Każdy model halucynuje. Pytanie tylko, czy program pomaga to wyłapać, czy wygładza odpowiedź tak, że błędu nie widać.
„Zero retention” bez wskazania warstwy. Model, proxy, aplikacja, kopie zapasowe. To są cztery różne odpowiedzi i warto poprosić o wszystkie.
9. AI Act i pytanie, kto tu jest dostawcą
Większość kancelarii będzie podmiotem stosującym. Z tej roli da się jednak wyjść, nie zawsze świadomie. AI Act przewiduje sytuacje, w których podmiot stosujący przejmuje obowiązki dostawcy: gdy opatrzy system własną nazwą lub znakiem, gdy istotnie go zmodyfikuje albo gdy zmieni jego przeznaczenie. Dla kancelarii budującej własną nakładkę na cudzym API to nie jest scenariusz akademicki.
Przy okazji jedna uwaga do oświadczeń o certyfikatach. Normy techniczne dla AI wciąż powstają, więc zapewnienie „mamy wszystkie wymagane certyfikaty” bywa dziś puste, bo w wielu miejscach nie ma jeszcze czego certyfikować. Sensowniej brzmi zobowiązanie, że dostawca uzyska je w terminie i poinformuje o tym klienta.
Skoro sam jestem dostawcą, powiem, jak to widzę. W mojej ocenie program dla kancelarii nie jest systemem wysokiego ryzyka. Załącznik III w części o wymiarze sprawiedliwości mówi o systemach używanych przez organy wymiaru sprawiedliwości lub w ich imieniu, a narzędzie pełnomocnika jest czym innym. Modeli nie trenuję ani nie tworzę, więc obowiązki dostawcy modeli ogólnego przeznaczenia też mnie nie dotyczą. Zostaje przejrzystość: użytkownik ma wiedzieć, że pracuje z AI, co program wysyła i dokąd, oraz ma dostać instrukcję. Zrobiłbym to nawet bez przepisu. I dobrze o tym pamiętać, czytając cudze materiały, bo hasło „zgodny z AI Act” w praktyce oznacza najczęściej dokładnie tyle: spełniamy obowiązki informacyjne. Nie jest to żaden certyfikat ani audyt.
10. Tajemnica zawodowa to osobny temat
Umowa powierzenia jest potrzebna z perspektywy RODO, ale nie uchyla tajemnicy zawodowej. Radca i adwokat mają własny reżim, psycholog pracuje na danych o zdrowiu, czyli na szczególnej kategorii danych. To dwie różne osie i zgodność na jednej nie daje zgodności na drugiej.
Dlatego pytanie „czy dostawca ma umowę powierzenia” jest dobre, ale za wąskie. Lepsze brzmi: czy te dane w ogóle muszą opuścić mój komputer.
Moja granica, której nie przekraczam…
Moja granica, której nie przekraczam, brzmi tak: dane identyfikujące, czyli nazwiska, adresy, numery i wszystko, co pozwala wskazać konkretną osobę, nie opuszczają komputera użytkownika. Ile się da – zostaje na komputerze. Na zewnątrz wychodzi tekst ze znacznikami, a klucz pozwalający je przywrócić zostaje u Ciebie. Do tego dochodzi ambicja, która jest trudniejsza: oddać prawnikowi możliwie dużą kontrolę nad tym, co i kiedy wychodzi, zamiast prosić go o zaufanie.
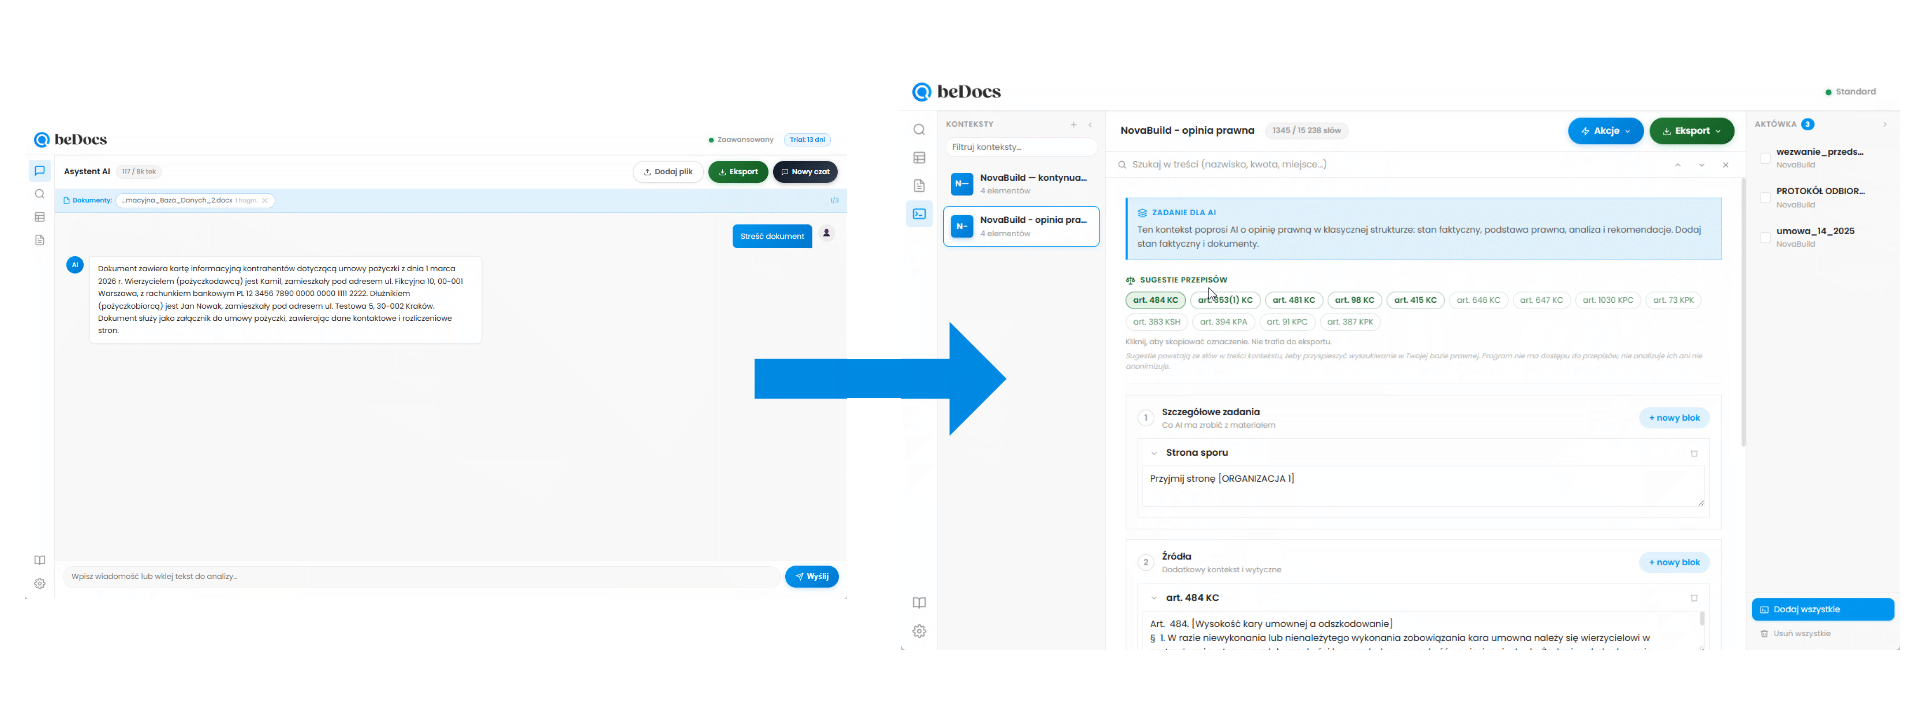
Z tego wynika cała reszta, łącznie z rzeczami, które kosztowały mnie funkcje i pieniądze. Zamiana danych na znaczniki i ich przywracanie dzieją się lokalnie, a bez tego kroku nic nie wychodzi na zewnątrz. Trzy z czterech modułów pracują w całości offline. Nic nie wychodzi bez Twojej świadomej decyzji, bo program sam z siebie nie wysyła niczego: zawsze musisz nacisnąć przycisk. Dotyczy to tak samo aktywacji licencji, sprawdzenia aktualizacji, wyszukiwarki aktów prawnych i orzeczeń, jak i wysyłki dokumentu do analizy. Z każdego zapytania do chmury wygenerujesz raport z sumą kontrolną i pełną treścią tego, co poszło i co wróciło. Wyrzuciłem też gotowy, działający moduł czatu, bo nie umiałem pogodzić go z tą zasadą przy sensownej jakości odpowiedzi. Kasowanie działającego kodu, nad którym pracowałem dość długo, nie jest przyjemne.
Nie proszę o zaufanie, bo wiem, ile jest warte. Proszę o sprawdzenie i podpowiadam, jak to zrobić na trzech poziomach.
Poziom pierwszy, pół minuty. Wyłącz wi-fi albo wyciągnij wtyczkę i pracuj dalej. Zobaczysz, które funkcje w ogóle nie potrzebują internetu.
Poziom drugi, kilka minut. Wyślij coś do analizy w chmurze i otwórz raport przetwarzania. Porównaj go z oryginałem. W miejscu nazwisk i adresów zobaczysz znaczniki, obok sumę kontrolną i pełną treść tego, co poszło i co wróciło.
Poziom trzeci, dla informatyka kancelarii. Podejrzyj ruch sieciowy programu. Wystarczy narzędzie pokazujące, z jakimi adresami łączy się aplikacja, na przykład Monitor zasobów w Windows. Zobaczysz, że dopóki nie klikniesz, program nie łączy się z niczym, a po kliknięciu ruch idzie w jedno miejsce. Kto chce iść dalej, może przepuścić ten ruch przez własne proxy i zobaczyć samą treść żądania, czyli znaczniki zamiast nazwisk. Zachęcam, bo to jedyny test, który nie opiera się na moim kodzie ani na moim słowie.
Trzeci poziom zrobi może jedna osoba na tysiąc i nie o to chodzi. Chodzi o to, że mogę go zaproponować. Architekturę sprawdzisz sam, przy własnym biurku. Obietnicy nie sprawdzisz w ten sposób nigdy, możesz ją najwyżej zapisać w umowie i liczyć, że nie zdarzy się nic, co ją unieważni.
Jeżeli chcesz zobaczyć, jak z tego założenia wyszły konkretne decyzje, pisałem o tym wcześniej, w materiale o powstaniu beScript i o trzech obawach prawników wobec AI, czyli o tym, jak powstawał beDocs. Sam program i jego opis znajdziesz tutaj (beDocs).
Najprościej sprawdzić to samemu. Wersję testową udostępniam po kontakcie, więc napisz do mnie, a dostaniesz program i będziesz mógł wykonać wszystkie trzy poziomy testu z tego wpisu na własnym komputerze i własnych plikach. Jeśli wolisz, żeby ktoś Cię przez to przeprowadził, umówimy się na prezentację i pokażę jak całość działa.
Autor wpisu: Kamil Jędryczka